
Auditoria técnica dos dados: 14,4 milhões de faces e reprodução completa
Prova condicional da amostragem por rejeição, 44 testes estatísticos, cinco gráficos e todas as sementes, dados brutos e scripts para auditar o Dicecore 3.7.1.
Coletamos 14.400.000 faces pela API pública do @erpg/dicecore@3.7.1, preservamos as 428.000 sementes utilizadas e reproduzimos todos os resultados. Nenhum dos 44 testes principais rejeitou seu modelo nulo após ajuste de Holm, com nível familiar de 1%. O pacote instalado também foi comparado ao arquivo oficial do npm: os 89 arquivos do motor e de licença conferem.
Este é um estudo interno de engenharia, publicado com código e dados para verificação externa. A conclusão é específica: as amostras são compatíveis com uniformidade das faces e independência dos pares examinados. A transformação de inteiros em faces tem uma prova matemática de ausência de viés de módulo sob a hipótese de palavras de origem uniformes e independentes. Uma amostra finita não prova aleatoriedade perfeita, e reprodução determinística não certifica proteção contra trapaça.
Você pode baixar o estudo completo, incluindo os dados brutos e as sementes, consultar os resultados sem arredondamento ou abrir a tabela CSV. O guia de reprodução contém os comandos completos. Os gráficos abaixo também estão no arquivo em SVG e PNG.
1. Qual caminho de execução foi auditado?
O frontend chama rollMixedDice pelo módulo público @erpg/dicecore/systems/mixed, com estas opções:
import { rollMixedDice } from "@erpg/dicecore/systems/mixed";

const result = rollMixedDice("1d20", {
  detail: "compact",
  randomAlgorithm: "xoshiro128ss",
});

console.log(result.dice.map((die) => die.rawValue));
O nome de configuração xoshiro128ss corresponde a *xoshiro128\\ 1.1, de Blackman e Vigna. É a escolha explícita do wrapper rollCompactMixedDice do site. O padrão da biblioteca, quando a opção é omitida, é MT19937*. Testamos ambos, identificando cada conjunto, sem confundir o padrão da biblioteca com a configuração do aplicativo. Veja o wrapper do frontend na revisão examinada e as implementações de xoshiro, MT19937 e contexto de execução.
Na operação sem semente fornecida, o motor solicita quatro palavras de 32 bits a crypto.getRandomValues: 128 bits de material de semente por chamada. Cada execução tem seu próprio estado do PRNG. Dentro de uma chamada 500d20, os 500 dados consomem a sequência desse estado; outra chamada cria uma nova semente. Se a fonte criptográfica não existe ou falha, essa implementação retorna RNG_UNAVAILABLE; não substitui silenciosamente a fonte por Math.random. O comportamento está em replay.ts; a API de entropia é definida na especificação Web Crypto.
Semente criptográfica e gerador criptográfico são propriedades diferentes. Xoshiro e MT19937 são PRNGs determinísticos não criptográficos. Não servem como garantia de imprevisibilidade contra quem conhece ou recupera o estado. O espaço e o período do gerador também não aumentam os 128 bits fornecidos pela semente. As referências dos próprios autores estão no projeto dos PRNGs de Blackman e Vigna e no projeto Mersenne Twister.
O dado 3D recebe um resultado que já existe
O caminho da ficha calcula a rolagem antes de enviar as faces ao adaptador 3D. rawValue é a face sorteada; materiais, texturas e movimento pertencem à apresentação. O estudo mede essas faces da API, não a orientação de uma malha ou os pixels de uma animação. A relação pode ser examinada no runtime da ficha e no adaptador 3D.
O escopo também importa: o backend/Fortuna possui uma implementação em Go. Este experimento não mediu esse runtime, os históricos de jogadores em produção ou todos os sistemas e modificadores disponíveis. Ele audita o pacote JavaScript identificado, pela mesma API e opção de algoritmo do frontend, em Node e em um navegador real.
2. Prova: por que a conversão para faces elimina o viés de módulo
Considere uma palavra inteira U uniforme em {0, …, Q−1}, com Q = 2^32. Para um dado com s lados, usar diretamente 1 + (U mod s) é uniforme somente quando s divide Q. Caso contrário, alguns resíduos têm uma pré-imagem a mais.
Os dois geradores implementam a conversão assim, em pseudocódigo:
Q = 2^32
L = floor(Q / s) * s
repita:
    U = próxima palavra UInt32
até U < L
face = 1 + (U mod s)
Escreva L = m·s. O intervalo aceito contém exatamente m inteiros com cada resíduo: para a face k, são k−1, k−1+s, …, k−1+(m−1)s. Condicionando à aceitação:
P(face = k | U < L) = m / L = m / (m*s) = 1/sSe as tentativas são uniformes e independentes, repetir até aceitar preserva essa distribuição. A rejeição depende da palavra bruta e não de qual face seria conveniente para alguém. Trata-se de uma operação anterior à existência da face; não se descartam rolagens concluídas para obter um histograma bonito.
Para d20, 2^32 = 214.748.364 × 20 + 16. Logo:
L = 4.294.967.280
P(rejeitar uma palavra) = 16 / 4.294.967.296 ≈ 3,725290298 × 10^-9
E[tentativas por face] = Q / L ≈ 1,000000003725
O pequeno tamanho dessa sobra não é motivo para ignorá-la. O algoritmo remove o viés de módulo por construção. Já a hipótese sobre a qualidade das palavras produzidas pelo PRNG exige análise separada: uma sequência determinística com estado finito não equivale a uma fonte infinita de variáveis IID.
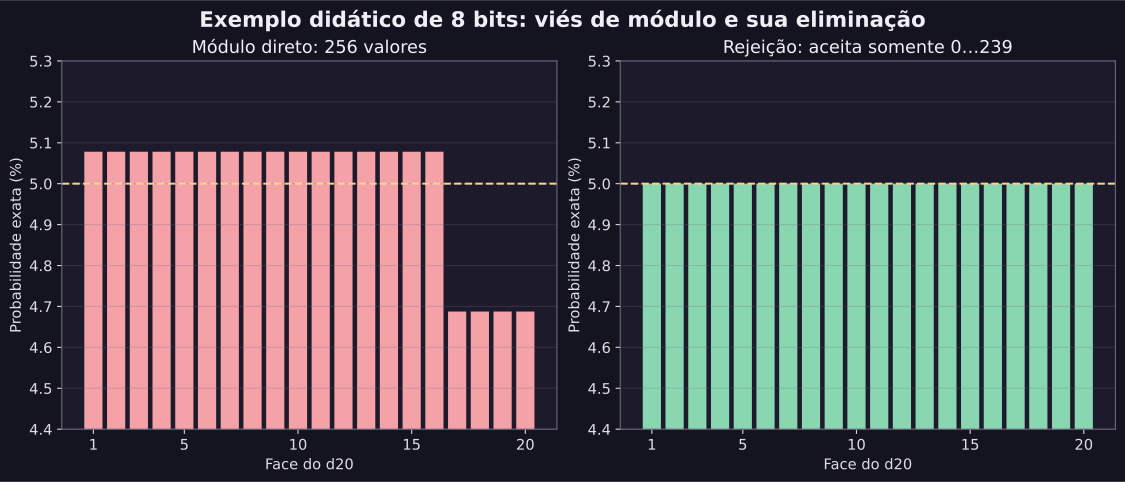
Figura 1 — demonstração didática, não amostra coletada. Em oito bits existem 256 valores. Módulo direto dá às faces 1–16 probabilidade 13/256 = 5,078125%, e às faces 17–20 12/256 = 4,6875%. Aceitar apenas 0–239 dá a todas 12/240 = 5%. O eixo vertical começa em 4,4% para mostrar a diferença; o motor real usa palavras de 32 bits. Abrir o SVG.
3. Protocolo fixado antes da análise
O protocolo original foi congelado em 2026-09-28T19:54:04Z; a coleta começou às 19:56:32Z, e a integração do conjunto do navegador terminou às 20:01:48Z. Essas são marcas internas registradas, não um pré-registro externo com certificação de data.
| Perfil | Algoritmo | Faces por dado | Conjuntos | | --- | --- | ---: | ---: | | Node, chamadas de 500 dados | xoshiro128ss | 1.000.000 | 7 | | Node, chamadas de 500 dados | mt19937 | 1.000.000 | 7 | | Node, nova semente por face | xoshiro128ss | 50.000 | 7 | | Chromium, nova semente por face | xoshiro128ss, d20 | 50.000 | 1 |
Os sete tipos são d4, d6, d8, d10, d12, d20, d100. São 22 conjuntos e 14,4 milhões de faces. Nos lotes, há 2.000 chamadas por conjunto. As fórmulas não têm reroll, explosão, seleção, bônus ou comparação; contamos todas as faces rawValue, em ordem de execução. Não há uma semente escolhida para produzir um resultado favorável.
A regra de seleção foi publicar a primeira coleta completa, inclusive se houvesse rejeições. Amostras menores de desenvolvimento são marcadas como smokeTest e recusadas pela análise de publicação. Não repetimos a coleta depois de consultar os testes. O protocolo tem SHA-256:
b84de0bc80d31fe22cca382f74476551b927cebbc17f1d6b5e4992264e293843O manifesto registra arquivos, hashes, fórmulas, versões dos descritores e ambiente. Foram utilizados Node 24.18.0, Chromium 154.0.8037.0 em contexto seguro de localhost, Python 3.12.14, NumPy 2.3.3, SciPy 1.16.3 e Matplotlib 3.10.7. O teste no navegador executou a biblioteca JavaScript com Web Crypto; não foi uma simulação de navegador feita em Node.
4. Testes e hipóteses
Uniformidade das faces
Para um dado de s lados, a hipótese nula é P(X=k)=1/s para todas as faces. Com N observações, O_k contagens e E_k=N/s, calculamos:
χ² = Σ [(O_k − E_k)^2 / E_k]
graus de liberdade = s − 1
O p-valor é a probabilidade, sob o modelo nulo, de uma estatística pelo menos tão grande quanto a observada. Ele não é a probabilidade de o dado ser justo. Usamos a aproximação qui-quadrado; todas as frequências esperadas são amplas, inclusive no d100. O método está descrito pelo NIST e implementado em SciPy chisquare.
Independência dos pares
Um histograma uniforme pode esconder uma sequência como 1,1,2,2,3,3,…. Por isso analisamos pares sem sobreposição: (X₁,X₂), (X₃,X₄), …. A tabela de contingência tem b=min(s,20) categorias por dimensão, com categoria floor((face−1)·b/s). No d100, cada categoria contém cinco faces consecutivas; nos demais dados, uma face por categoria.
Para cada célula (i,j), a expectativa de independência é E_ij = O_i· O_·j / n_pares. A estatística de Pearson tem (b−1)^2 graus de liberdade. Usamos chi2_contingency(..., correction=False) e verificamos que toda expectativa de célula é pelo menos 5. São 500.000 pares por conjunto em lote e 25.000 por conjunto de sementes novas. Veja SciPy chi2_contingency.
Este teste procura dependência entre categorias em pares adjacentes. Não testa todos os padrões de ordem superior, e o agrupamento do d100 perde resolução dentro de cada grupo. Pares sem sobreposição evitam o problema de tratar observações sobrepostas como se fossem independentes; ainda pressupomos o modelo IID para calibrar os testes.
Uma família de 44 testes, com ajuste de Holm
Há dois testes principais por conjunto. Aplicamos Holm aos 44 p-valores juntos, com α=0,01. Ordenando os p-valores como p_(1) ≤ … ≤ p_(44), o valor ajustado na posição i é:
p_Holm(i) = min(1, max_{j ≤ i} [(44 − j + 1) · p_(j)])Isso controla o erro familiar sob p-valores válidos, inclusive quando os testes não são independentes. Assim, o limiar não é escolhido depois de observar qual dado pareceu mais irregular. A documentação estatística do R explica o procedimento e referencia Holm (1979).
5. Resultados observados
Cada entrada abaixo usa um milhão de faces em Node. São p-valores de uniformidade sem ajuste, publicados para que a correção possa ser conferida.
| Dado | p, xoshiro128ss | p, MT19937 | | --- | ---: | ---: | | d4 | 0,214236 | 0,675186 | | d6 | 0,014352 | 0,335624 | | d8 | 0,914879 | 0,880731 | | d10 | 0,680304 | 0,217666 | | d12 | 0,925451 | 0,122686 | | d20 | 0,187065 | 0,295332 | | d100 | 0,509777 | 0,503956 |
O menor p-valor bruto de toda a família foi o do d6/xoshiro em lote, 0,014352398611…. Seu p-valor de Holm é 0,631505538885…; os outros 43 valores ajustados são 1. Zero rejeições no limiar familiar de 0,01. Um p-valor ajustado igual a 1 é consequência da correção e do truncamento, não um certificado de perfeição.
No perfil de semente nova por face, os p-valores de uniformidade em Node foram 0,781750 (d4), 0,871192 (d6), 0,669452 (d8), 0,826996 (d10), 0,062821 (d12), 0,779478 (d20) e 0,595757 (d100). No Chromium, d20 produziu χ²=12,2712, com 19 graus de liberdade e p=0,873708. Todos os p-valores de independência ajustados também são 1. Consulte os 22 registros completos, inclusive estatísticas seriais e tamanhos de efeito.
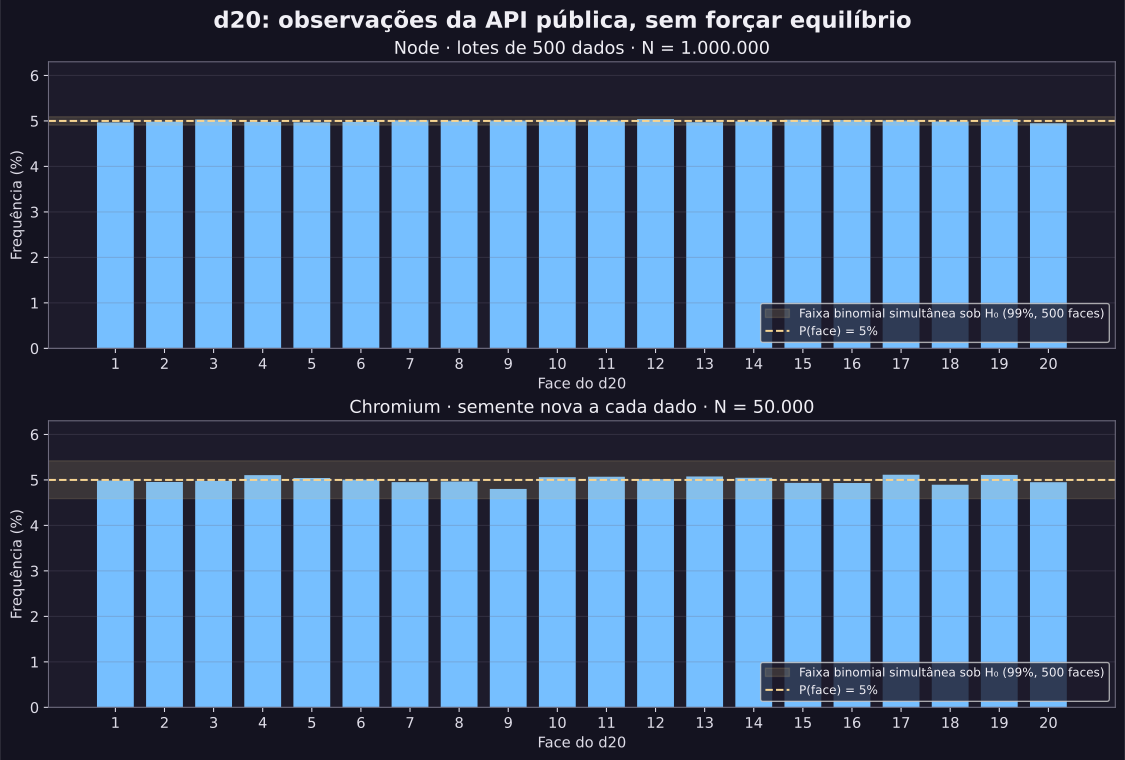
Figura 2 — dados efetivamente coletados, xoshiro128ss. A linha indica 5%. A faixa sombreada é uma referência binomial simultânea sob uniformidade, descrita na próxima seção. O eixo começa em zero para preservar a escala das diferenças. Abrir o SVG.
No d20/xoshiro em lote, a média foi 10,50494, contra 10,5 no modelo; a variância amostral foi 33,19584, contra 33,25. A face 20 ocorreu 49.487 vezes e a face 12 50.412 vezes, em vez de uma obrigação de 50.000 cada. A maior diferença absoluta foi 0,0513 ponto percentual. No navegador, a maior diferença foi 0,198 ponto percentual, com amostra vinte vezes menor.
Média e variância são verificações descritivas, não dois testes adicionais da família principal. Os registros incluem também a distância de variação total empírica TV = ½ Σ |O_k/N − 1/s|, que mede o tamanho agregado do desvio observado, sem convertê-lo automaticamente em viés populacional.
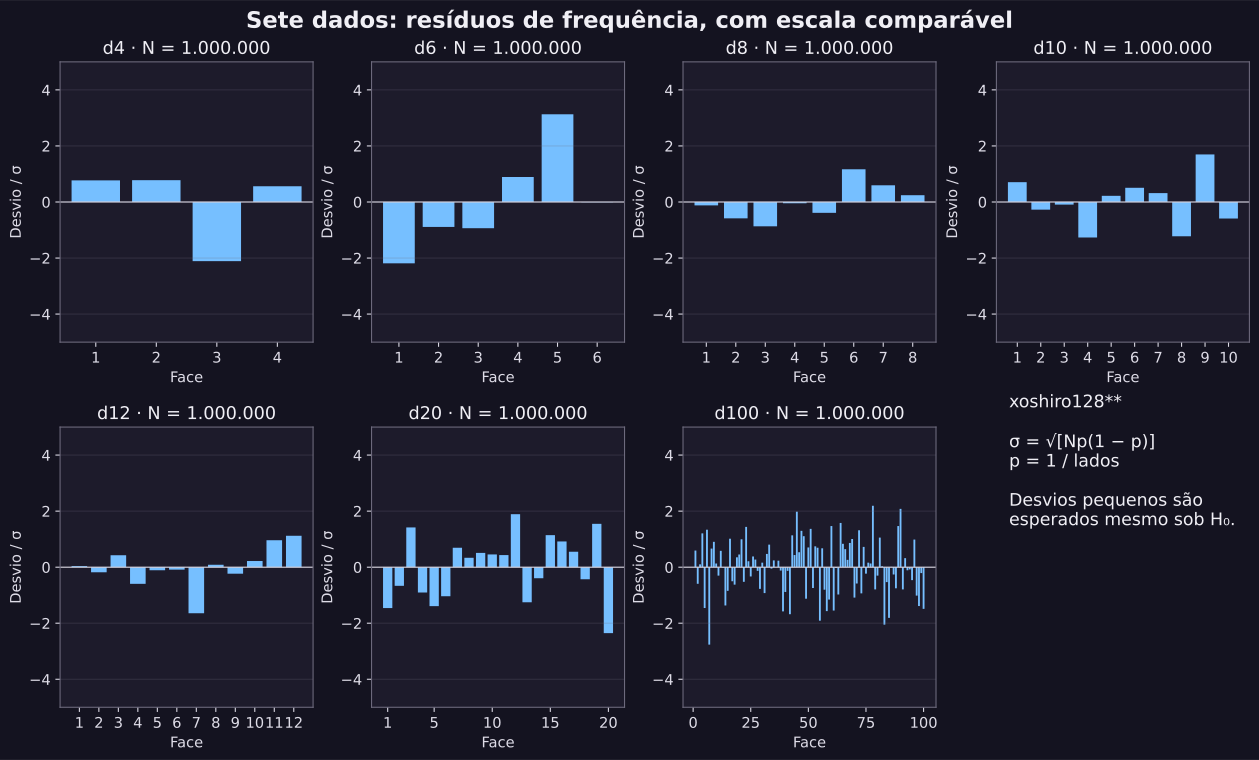
Figura 3 — resíduos comparáveis. Cada barra é (O−Np)/sqrt(Np(1−p)), com p=1/s. As faces de um mesmo histograma são dependentes entre si porque suas contagens somam N; este painel é descritivo, não uma coleção de testes normais independentes. Abrir o SVG.
6. Incerteza: intervalos individuais e faixas simultâneas
Publicamos intervalos binomiais exatos de Clopper–Pearson a 95% por face. Para a face 1 do d20/xoshiro em lote, a frequência foi 49.682/1.000.000 = 4,9682%, com intervalo de aproximadamente [4,92569%; 5,01097%]. Para a face 20, o intervalo individual é aproximadamente [4,90627%; 4,99139%], que não inclui 5%.
Isso não contradiz o teste global: examinar centenas de intervalos individuais cria oportunidades para aparentes exceções. Intervalos de 95% individuais não garantem cobertura de 95% para todas as faces simultaneamente. Não escolhemos uma face depois da coleta para substituir a hipótese principal.
As figuras usam outra construção: faixas de referência sob H₀, calculadas pelos quantis da binomial Bin(N,1/s), com Bonferroni para as 500 contagens de faces dos 22 conjuntos. Cada cauda recebe 0,01/(2×500). Sob o modelo, a probabilidade de alguma contagem ficar fora de sua faixa é no máximo 1%, respeitada a discretização. Essas faixas são expectativas para contagens de um modelo justo; não intervalos de confiança simultâneos estimados para as probabilidades desconhecidas.
Para o d20 com N=1.000.000, a faixa é 49.073–50.932 por face; com N=50.000, 2.295–2.710. Nenhuma das 500 contagens saiu da sua faixa. O ajuste dessas faixas é separado do Holm dos testes principais. O código das duas construções está em analyze.py; uma implementação de referência para o intervalo exato está na API binomial do SciPy.
7. Dependência linear e o que ela não detecta
Estimamos a autocorrelação nas defasagens 1–20:
r(h) = Σ_{t=1}^{N−h} [(X_t − média)(X_{t+h} − média)]
       / Σ_{t=1}^{N} (X_t − média)^2
É uma inspeção exploratória. Há 440 coeficientes nos 22 conjuntos. A faixa de referência usa a aproximação normal z_(1−0,01/(2×440))/sqrt(N), com Bonferroni. O gráfico mostra a faixa para N=50.000, mais larga que a de N=1.000.000. O maior módulo no d20/xoshiro em lote foi 0,001950; no d20/Node com semente nova, 0,007844; no d20/Chromium, 0,010067.
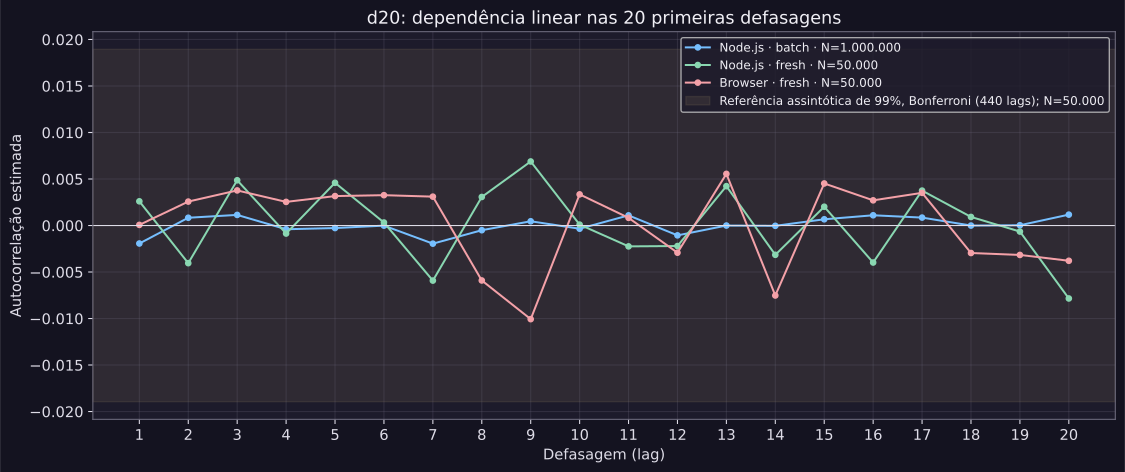
Figura 4 — diagnóstico exploratório. Correlação linear pequena não exclui dependência não linear, dependência em outras defasagens ou estrutura de ordem superior. A faixa é assintótica, não uma garantia exata. Estes coeficientes não são novos testes principais nem uma aprovação em TestU01/BigCrush. Abrir o SVG.
8. Vantagem, desvantagem e somas não são uniformes
Auditar a face original é diferente de exigir uniformidade do resultado depois de aplicar regras. Se X,Y são d20 justos independentes:
P(max(X,Y) = k) = (k/20)^2 − ((k−1)/20)^2 = (2k−1)/400
P(min(X,Y) = k) = ((21−k)/20)^2 − ((20−k)/20)^2 = (41−2k)/400
Portanto, a chance de obter 20 com vantagem é 39/400 = 9,75%, e a chance de 1 é 1/400 = 0,25%. Na desvantagem, as probabilidades se invertem. Para a soma T de dois d6, P(T=t)=(6−|7−t|)/36, para 2≤t≤12; 7 é seis vezes mais provável que 2.
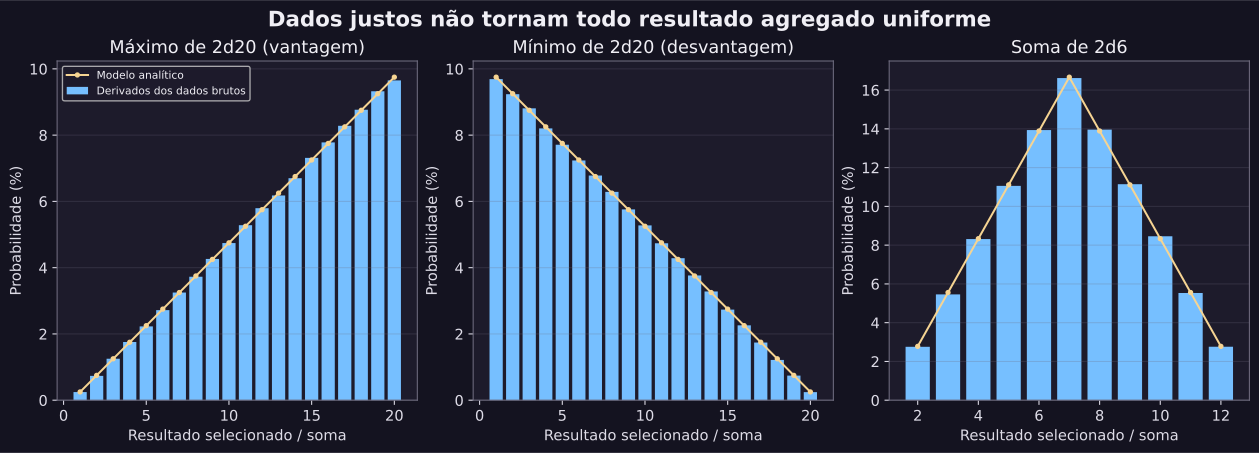
Figura 5 — transformação dos mesmos dados. Cada painel usa 500.000 pares disjuntos dos conjuntos em lote já publicados. Não são mais 1,5 milhão de novas rolagens, nem testes independentes da implementação de todos os modificadores. A figura ilustra por que keep highest, somas e resultados condicionados a sucesso pedem modelos diferentes. Abrir o SVG.
9. Reprodução determinística: o que é possível verificar
Um descritor de replay registra algoritmo, versão do algoritmo e da execução, perfil matemático, material de semente e fingerprint do plano. Para a API mista, esses dados ficam dentro de result.replay.rolls. A fórmula e o descritor devem ser preservados juntos:
import assert from "node:assert/strict";
import { rollMixedDice } from "@erpg/dicecore/systems/mixed";

const original = rollMixedDice("3d20", {
  detail: "compact",
  randomAlgorithm: "xoshiro128ss",
});
const repeated = rollMixedDice("3d20", {
  detail: "compact",
  replay: original.replay,
});
assert.deepEqual(
  repeated.dice.map((die) => die.rawValue),
  original.dice.map((die) => die.rawValue),
);
No estudo, cada .u8 armazena uma face por byte. Cada .seeds contém 16 bytes por chamada, obtidos do hexadecimal de seedMaterial. O manifesto fornece o template completo de replay para cada fórmula. collect.mjs --verify reconstrói cada chamada e compara cada face, além de conferir hashes e arquivos do motor. Esta verificação passou para as 14,4 milhões de faces, inclusive as 50.000 produzidas no Chromium.
O replay prova consistência entre entradas e saídas do motor identificado. Não prova que uma pessoa não procurou previamente uma semente vantajosa, que o cliente não foi alterado ou que um histórico foi transmitido sem adulteração. Para essas propriedades seria necessário outro protocolo, por exemplo compromisso prévio e verificação de autoridade. O campo origin: "crypto" de um JSON publicado também não é uma assinatura criptográfica independente da coleta.
10. Guia de reprodução
Baixe e extraia study.zip em uma pasta vazia. Use Node ≥22 e Python compatível com as versões fixadas; o ambiente exato desta coleta está registrado acima. Abra o terminal nessa pasta:
npm init -y
npm install --ignore-scripts --save-exact @erpg/dicecore@3.7.1
python -m venv .venv
Ative o ambiente com source .venv/bin/activate no Linux/macOS ou .\.venv\Scripts\Activate.ps1 no PowerShell. Você também pode chamar diretamente o Python de .venv, sem ativação.
python -m pip install -r requirements.txt
python verify_package.py --data data --out verified-package.json
python self_test.py
node collect.mjs --verify --out data
python analyze.py --data data --out reproduced-analysis
Os dois primeiros scripts verificam o pacote oficial e os controles da análise. A verificação de replay não gera uma nova amostra: ela restaura as sementes publicadas. A análise recalcula as estatísticas e as cinco figuras a partir dos arquivos brutos. Compare os campos científicos com analysis/statistics.json; pequenas diferenças numéricas entre plataformas e metadados de runtime não implicam faces diferentes.
Para um experimento independente, use node collect.mjs --out new-data. Sirva os arquivos locais com python -m http.server 8080 --bind 127.0.0.1, abra http://127.0.0.1:8080/browser.html, baixe seus três arquivos e importe com node collect.mjs --import-browser browser-dataset.json --out new-data. A análise exige os 22 conjuntos. Novas sementes produzem novas contagens: publique também resultados desfavoráveis e não repita até conseguir aprovação. O README explica diretórios, formatos, checksums e reconstrução do bundle do navegador.
Os controles positivos usam contagens equilibradas, viés artificial e marginais equilibradas com pares repetidos. A mesma função usada no estudo detectou os dois problemas artificiais; Holm foi comparado a um exemplo calculado à mão, e os intervalos à implementação exata do SciPy. Os scripts de controle estão publicados para que o resultado favorável não dependa de uma análise incapaz de encontrar erros.
11. Biblioteca, código-fonte, licença e integridade
A dependência medida é o pacote npm 3.7.1, cujo artefato declara MIT e contém a licença preservada neste estudo. O repositório público do fork permite inspeção do código, mas sua licença atual possui termos próprios da Arkanus. Disponibilidade pública do fonte não torna automaticamente todos os releases e branches software livre sob os mesmos termos. Consulte a licença do artefato e da revisão que pretende utilizar. A biblioteca original upstream também pode ser consultada.
A revisão de fonte examinada foi 1940044c34c47a3c55faa723ccb0d524eef79b03. Como a metadata do pacote não identifica gitHead, não afirmamos que essa revisão produziu o tarball publicado. A identificação executável é feita pelos bytes do pacote, sua integridade e os fingerprints do manifesto, não por presumir uma correspondência de versão com um commit.
Pacote: @erpg/dicecore@3.7.1
SRI SHA-512 do tarball:
sha512-3Aa8dkiJLwXOMGktEj3lZXJtHqYLaGUSeRLuFKqaP795lVmSYPW9gjY26IY8LTiWXSmTbFvBjEa9IlBWRQbUCg==

SHA-256 do tarball:
d4defb2ff92b9bf56cb3ed2ba9cee276d18d2ba9ae4ba2f09d2b08c013d368a9
O relatório da verificação do pacote, o registro de evidências e escopo e a lista de checksums dos downloads completam a trilha. Hashes ajudam a conferir identidade dos arquivos; não substituem uma assinatura ou auditoria independente.
12. Até onde vai a conclusão
O estudo fornece três evidências verificáveis: uma transformação que elimina viés de módulo sob suas hipóteses; faces observadas compatíveis com os modelos estatísticos definidos; e reprodução integral dos resultados com o motor identificado. Esse conjunto sustenta o uso auditável dos dados comuns examinados.
As limitações são concretas: sete tipos de dado, 22 perfis, dois PRNGs, um navegador e um ambiente Node; testes de pares e correlação de alcance limitado; aproximações qui-quadrado e normal; ausência de uma análise de potência para todas as alternativas. Não detectar viés não impõe um limite universal a todo viés possível. Como detalhe de implementação, o estado xoshiro de 128 bits inteiramente zero recebe um reparo determinístico; o comportamento de todos os estados não é provado pelo histograma coletado.
Também não se certificam segurança criptográfica, resistência a adulteração do cliente, o runtime Go, cada modificador, todas as plataformas ou a versão atualmente servida a cada visitante. Uma atualização do pacote, do algoritmo ou da inicialização exige identificar os novos bytes e repetir a avaliação. Ao citar este trabalho, cite versão, protocolo e resultados, mantendo essas fronteiras.
Para experimentar a interface, abra o rolador de dados. Para entender por que sequências de azar continuam acontecendo sob um modelo justo, leia Por que dados justos parecem viciados. Para verificar esta conclusão, use os arquivos publicados: a reprodução depende dos dados e dos scripts, não de confiança no texto.